数据导入和数据整理
首先导入所需包。
# 数据整理
import numpy as np
import pandas as pd
# 可视化
import matplotlib.pyplot as plt
import seaborn as sns
import plotly as py
import plotly.graph_objs as go
import plotly.express as px
from plotly.offline import init_notebook_mode, iplot, plot
init_notebook_mode(connected=True)
plt.style.use('seaborn')
# 读入数据
df_2015 = pd.read_csv('./deal_data/2015.csv')
df_2016 = pd.read_csv('./deal_data/2016.csv')
df_2017 = pd.read_csv('./deal_data/2017.csv')
df_2018 = pd.read_csv('./deal_data/2018.csv')
df_2019 = pd.read_csv('./deal_data/2019.csv')

# 新增列-年份
df_2015["year"] = str(2015)
df_2016["year"] = str(2016)
df_2017["year"] = str(2017)
df_2018["year"] = str(2018)
df_2019["year"] = str(2019)

# 合并数据
df_all = df_2015.append([df_2016, df_2017, df_2018, df_2019], sort=False)
df_all.drop('Unnamed: 0', axis=1, inplace=True)
df_all.head()
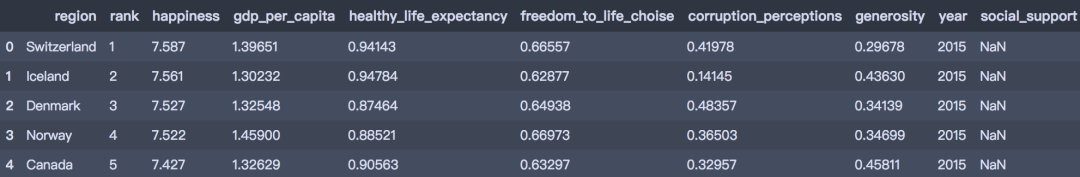
print(df_2015.shape, df_2016.shape, df_2017.shape, df_2018.shape, df_2019.shape)
(158, 10) (157, 10) (155, 10) (156, 11) (156, 11)
<class 'pandas.core.frame.DataFrame'>
Int64Index: 782 entries, 0 to 155
Data columns (total 10 columns):
region 782 non-null object
rank 782 non-null int64
happiness 782 non-null float64
gdp_per_capita 782 non-null float64
healthy_life_expectancy 782 non-null float64
freedom_to_life_choise 782 non-null float64
corruption_perceptions 781 non-null float64
generosity 782 non-null float64
year 782 non-null object
social_support 312 non-null float64
dtypes: float64(7), int64(1), object(2)
memory usage: 67.2+ KB
数据可视化
2019世界幸福地图
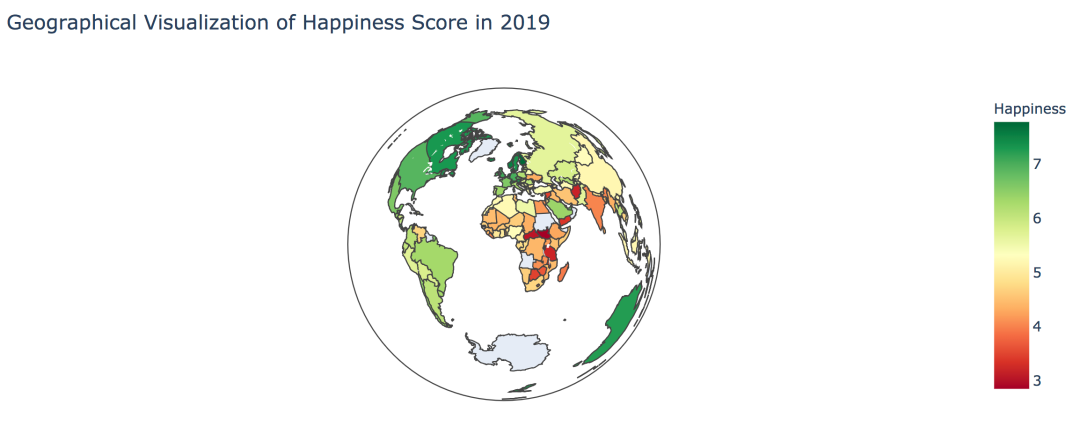
整体来看,北欧的国家幸福指数较高,如冰岛、丹麦、挪威、芬兰;东非和西非的国家幸福指数较低,如多哥、布隆迪、卢旺达和坦桑尼亚。
代码展示:
data = dict(type = 'choropleth',
           locations = df_2019['region'],
           locationmode = 'country names',
           colorscale = 'RdYlGn',
           z = df_2019['happiness'],
           text = df_2019['region'],
           colorbar = {'title':'Happiness'})

layout = dict(title = 'Geographical Visualization of Happiness Score in 2019',
              geo = dict(showframe = True, projection = {'type': 'azimuthal equal area'}))

choromap3 = go.Figure(data = [data], layout=layout)
plot(choromap3, filename='./html/世界幸福地图.html')
2019世界幸福国家排行Top10
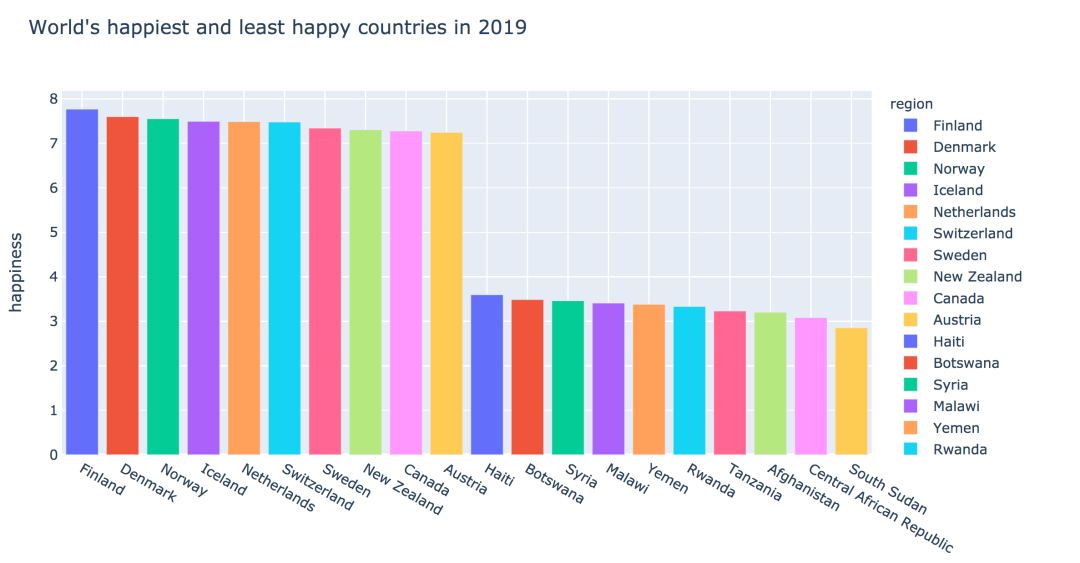
2019年报告,芬兰连续两年被评为“全球最幸福国家”。丹麦、挪威、冰岛、荷兰进入前五名,对比2018年报告,中国从86名下降到93名。
代码展示:
# 合并数据
rank_top10 = df_2019.head(10)[['rank', 'region', 'happiness']]
last_top10 = df_2019.tail(10)[['rank', 'region', 'happiness']]
rank_concat = pd.concat([rank_top10, last_top10])

# 条形图
fig = px.bar(rank_concat,
             x="region",
             y="happiness",
             color="region",
             title="World's happiest and least happy countries in 2019")

plot(fig, filename='./html/2019世界幸福国家排行Top10和Last10.html')
幸福指数相关性
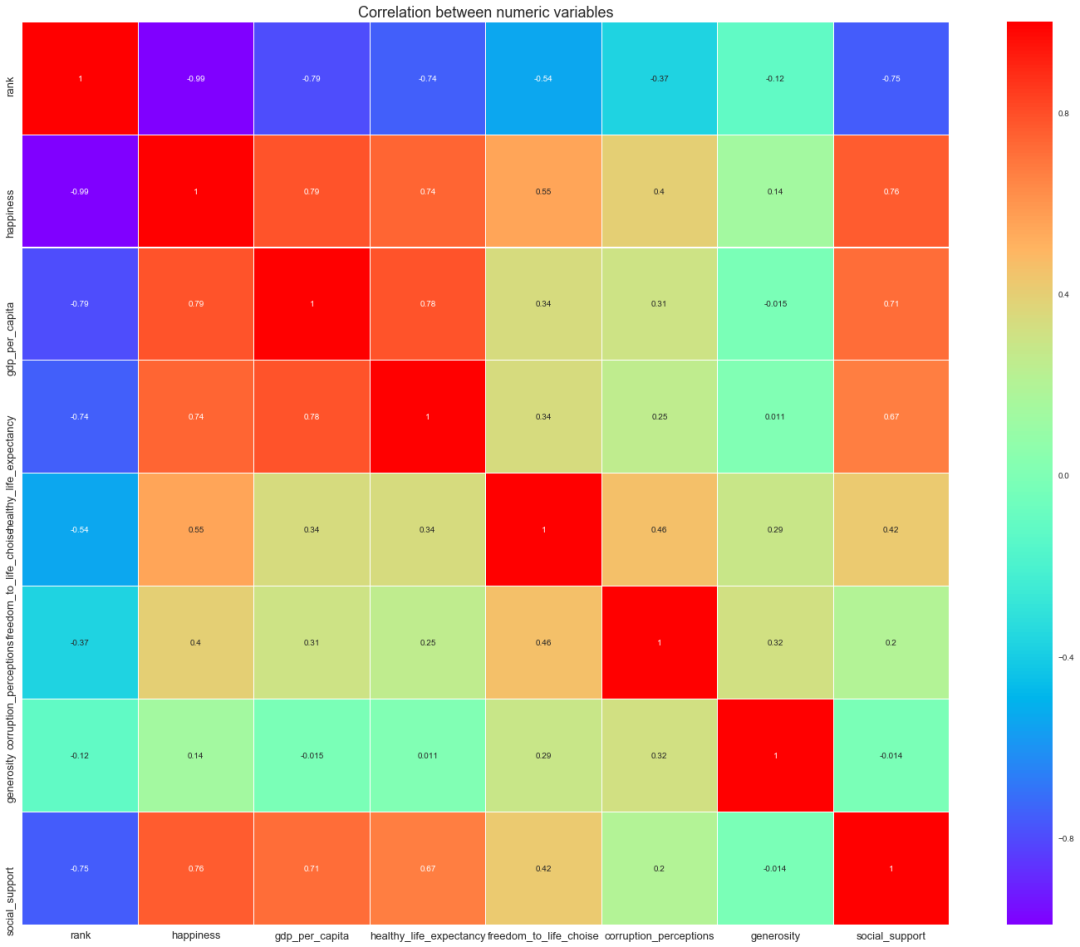
我们可以得出以下结论:
以下分别观察各个因素的影响程度。
GDP和幸福得分
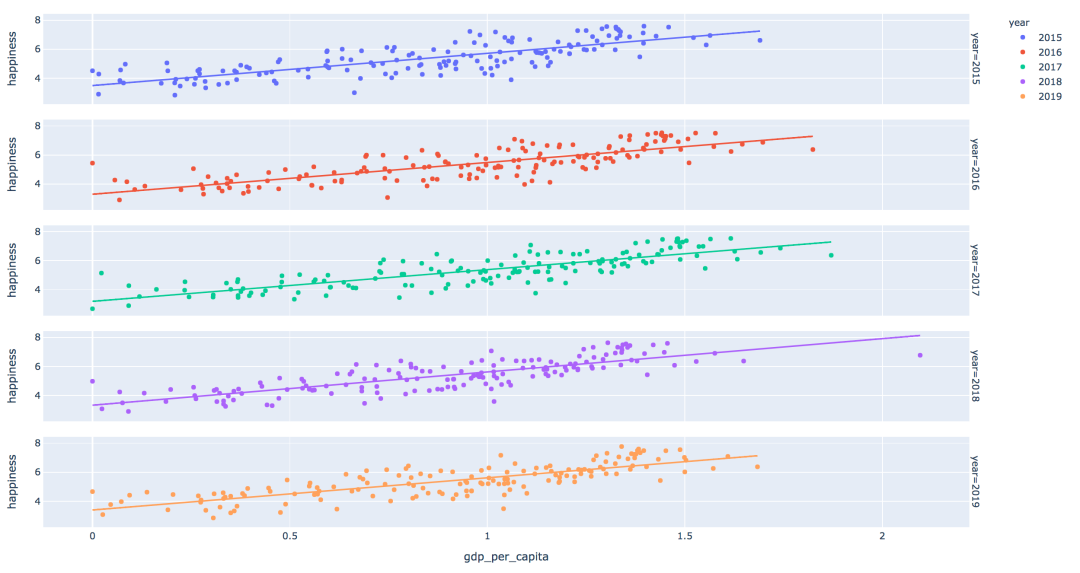
人均GDP与幸福得分呈高度线性正相关关系,GDP越高的国家,幸福水平相对越高。
代码展示:
# 散点图
fig = px.scatter(df_all, x='gdp_per_capita',
                 y='happiness',
                 facet_row='year',
                 color='year',
                 trendline='ols'
                )
fig.update_layout(height=800, title_text='GDP per capita and Happiness Score')
plot(fig, filename='./html/GDP和幸福得分.html')
健康预期寿命和幸福得分
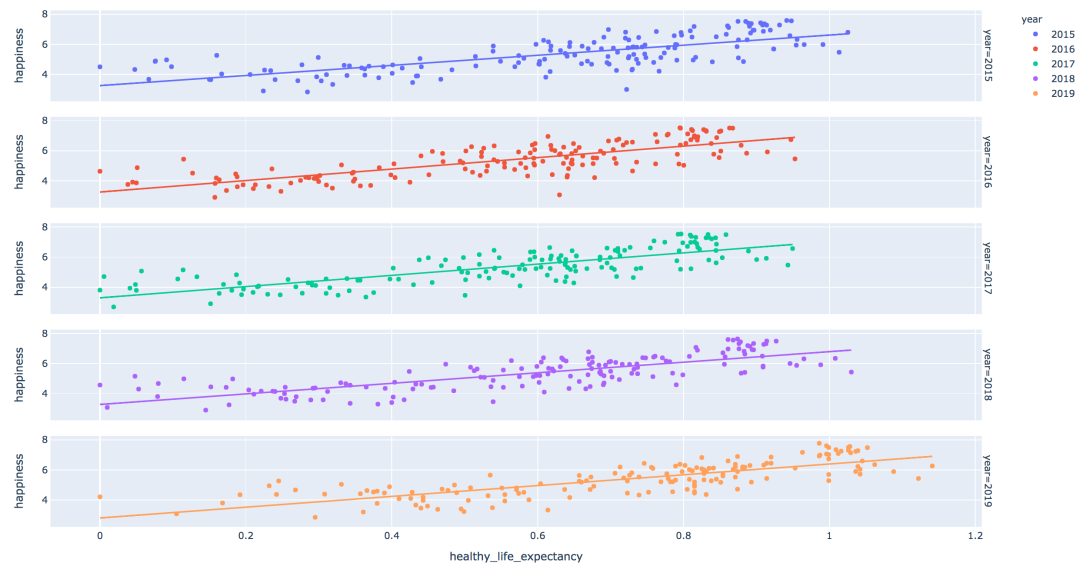
健康预期寿命与幸福得分呈高度线性正相关关系,健康预期寿命越高的国家,幸福水平相对越高。
代码展示:
散点图
fig = px.scatter(df_all, x='healthy_life_expectancy',
y='happiness',
facet_row='year',
color='year',
trendline='ols'
)
fig.update_layout(height=800, title_text='Healthy Life Expecancy and Happiness Score')
plot(fig, filename='./html/健康预期寿命和幸福得分.html')
GDP和幸福水平动态图
代码展示:
fig = px.scatter(df_all,
                 x='gdp_per_capita',
                 y='happiness',
                 animation_frame='year',
                 animation_group='region',
                 size='rank',
                 color='region',
                 hover_name='region',
                 trendline='ols'
                )
fig.update_layout(title_text='Happiness Rank vs GDP per Capita')
plot(fig, filename='./html/GDP和幸福水平动态图展示.html')
健康预期寿命和幸福水平动态图
代码展示:
fig = px.scatter(df_all,
                 x='healthy_life_expectancy',
                 y='happiness',
                 animation_frame='year',
                 animation_group='region',
                 size='rank',
                 color='region',
                 hover_name='region',
                 trendline='ols'
                )
fig.update_layout(title_text='Happiness Rank vs healthy_life_expectancy')
plot(fig, filename='./html/健康预期寿命和幸福水平动态图展示.html')
数据建模
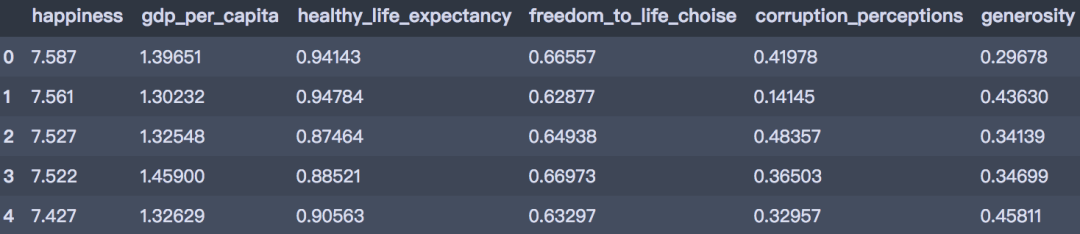
我们使用线性回归进行建立一个基准模型,首先筛选一下建模变量,并删除空值记录。
sel_cols = ['happiness', 'gdp_per_capita', 'healthy_life_expectancy',
            'freedom_to_life_choise', 'corruption_perceptions', 'generosity']
# 重置索引
df_model.index = range(df_model.shape[0])
df_model = df_all[sel_cols]
# 删除空值
df_model = df_model.dropna()
df_model.head()
from statsmodels.formula.api import ols

# 建立多元线性回归模型
lm_m = ols(formula='happiness ~ gdp_per_capita + healthy_life_expectancy + freedom_to_life_choise + corruption_perceptions + generosity',
           data=df_model).fit()
lm_m.summary()
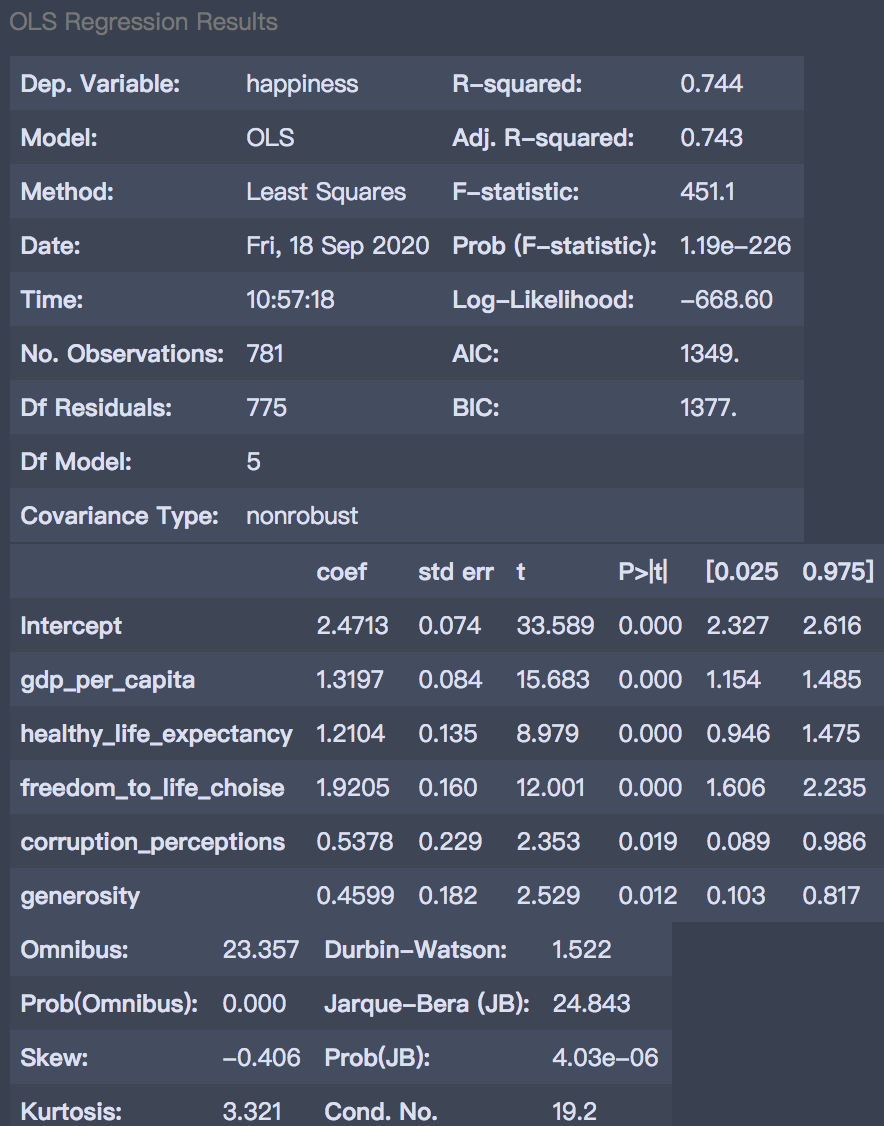
模型的R-squared=0.744,拟合效果尚可,根据模型的参数可知:
- 变量重要性排序为:gdp_per_capita、freedom_to_life_choise、healthy_life_expectancy、corruption_perceptions、generosity
- 控制其他变量不变的情况下,GDP指数每增加一个单位,幸福指数增加1.32个单位,健康预期寿命指数每增加一个单位,幸福指数增加1.21个单位。
比较预测值和真实值的分布:
df_pred = pd.concat([df_model['happiness'], y_pred], axis=1)
df_pred.columns = ['y_true', 'y_pred']

# 散点图
fig = px.scatter(df_pred, x='y_true', y='y_pred', trendline='ols')
fig.update_layout(title='Resid of OLS Regression')
plot(fig, filename='./html/预测值和真实值分布图.html')
以下为模型残差分布图。



