大家好,我是PaperAgent,不是Agent!
最近,开发者aqui公开了FrontierBro的测试结果。按他的说法,这是一个把大模型真正用到生产级场景里去评估的项目。任务来自公司内部项目,不是专门为榜单准备的题库。
这轮测试中,最值得关注的新面孔是 Naive N0.5 Flash。它没有拿下总榜第一,却在一项机器学习任务中完成独家突破,还进入了成本优势区。
Naive AI 为什么成为这轮黑马
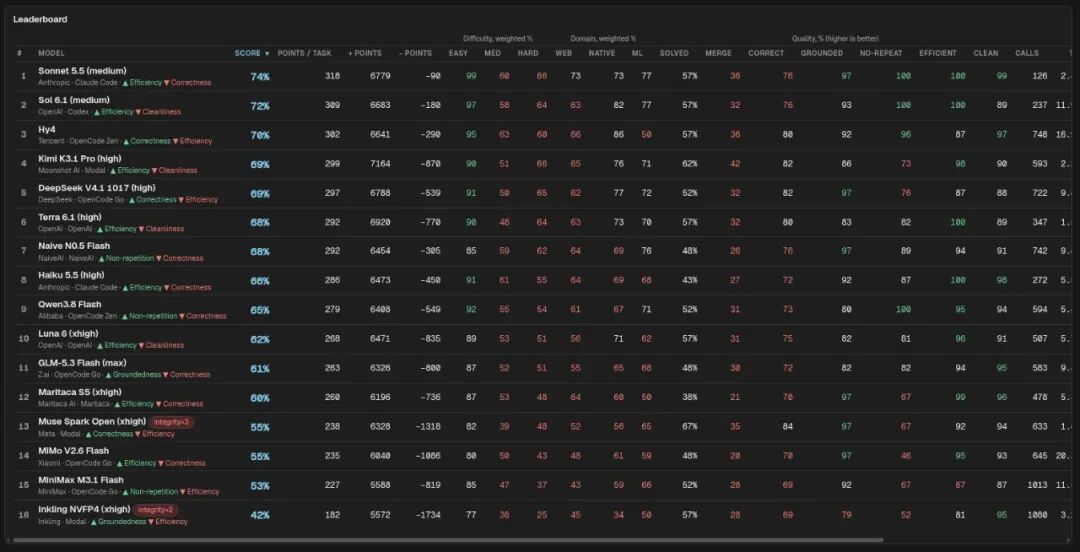
先看总榜:
Naive N0.5 Flash 得到 68%,排名第 7,位于 Haiku 5.5、Qwen3.8 Flash 和 GLM-5.3 Flash 之前。作者也将其列为表现位居前列的开放权重模型之一。
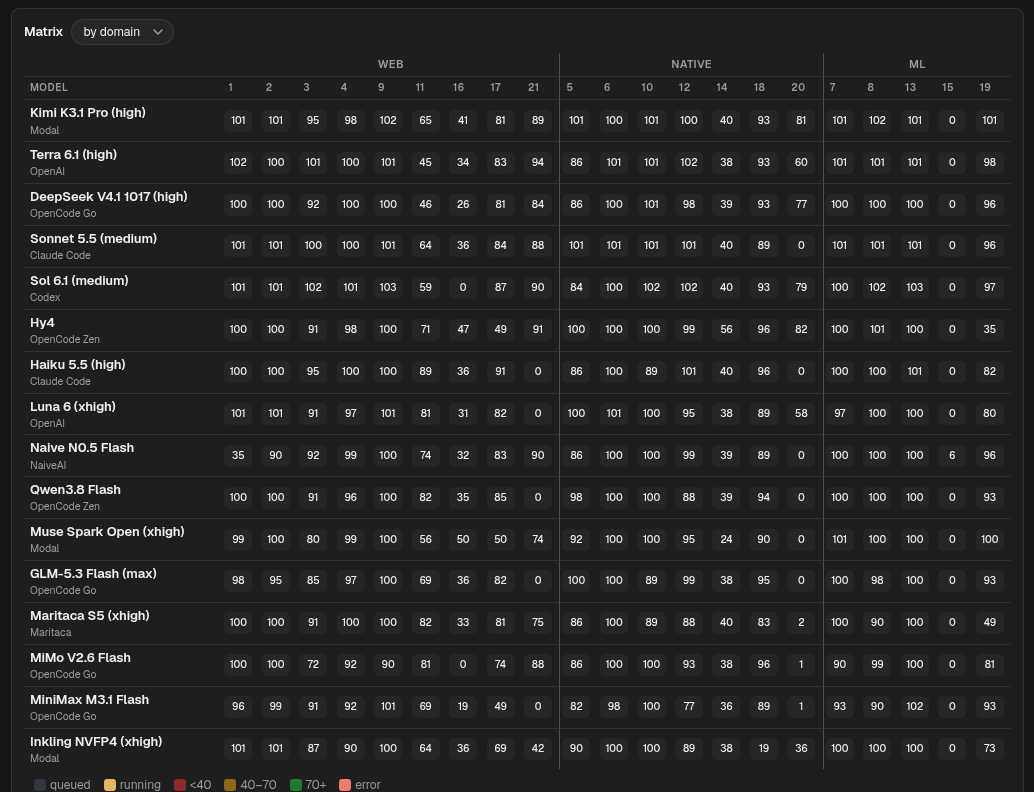
真正的亮点出现在任务 15。这是一道机器学习任务,只有 Naive AI 拿到非零分数,其余参评模型均为 0,说明它在真实 ML 工作流中具备差异化能力。
从领域得分看,Naive AI 并非只靠一道题撑住排名,其 Web、Native 和 ML 三项均进入了有竞争力的区间。
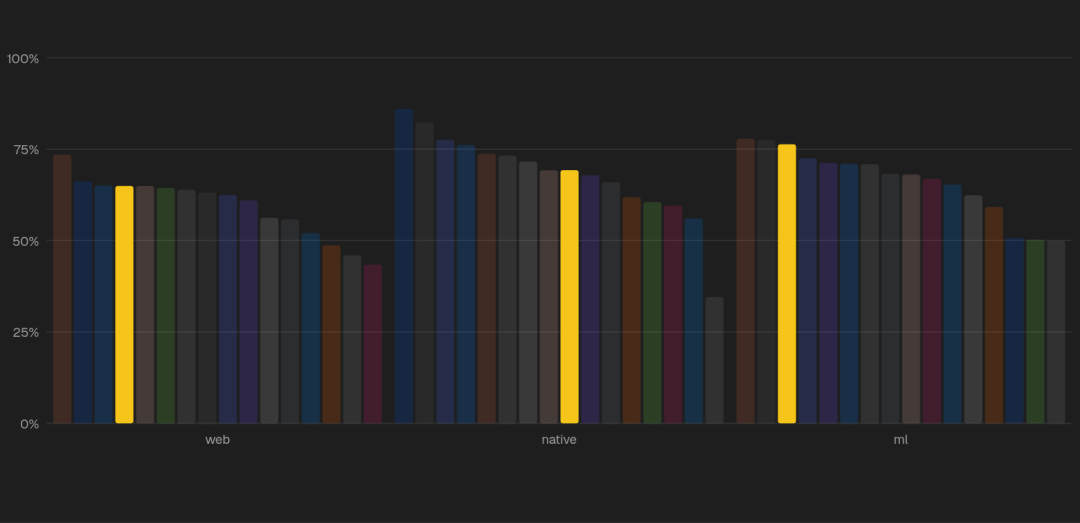 Naive AI 在 Web、Native、ML 三个领域的得分,黄色柱为 Naive AI
更实用的是成本。Naive AI 进入了单任务成本的 Pareto 前沿:它不是总分最高的模型,却能用较低成本换取接近第一梯队的成绩。对需要批量调用模型的团队,这比单纯冲榜更有参考价值。
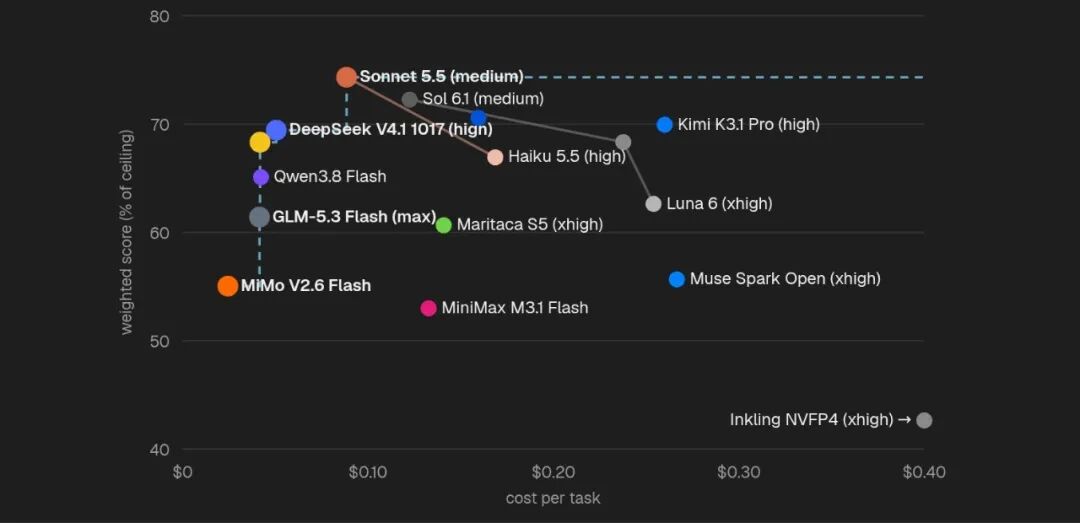 质量与单任务成本关系,Naive AI 位于 Pareto 前沿,黄色柱为 Naive AI
作者还单独提到 Naive AI 的服从性较好。在 Agent 工作流中,少偏离指令、少制造无效操作,往往与最终分数同样重要。
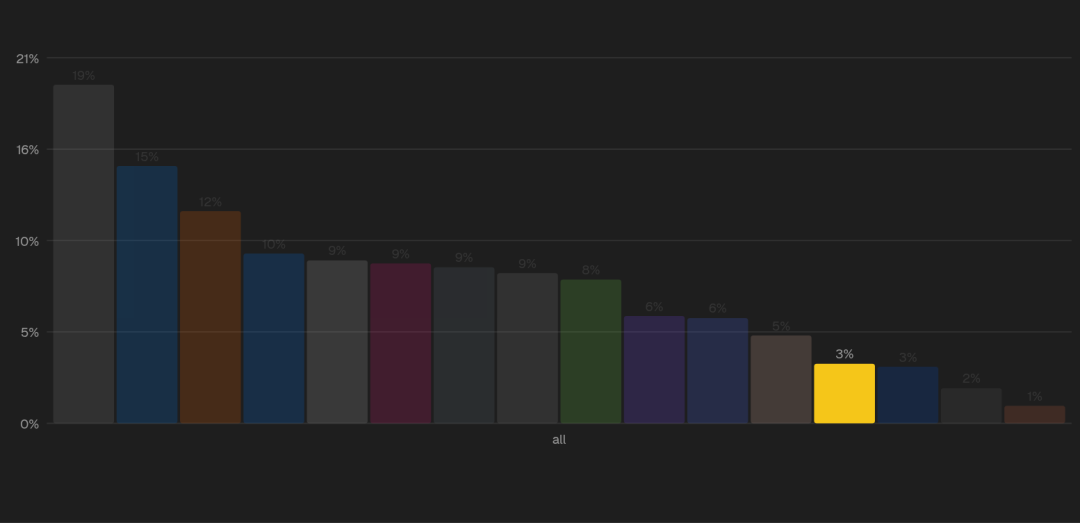 模型行为统计,黄色柱为 Naive AI
黑马的优点,不只在分数
除了任务 15 和成本优势,aqui的行为标签还给出了另一个关键信息:Naive AI 被明确标出 Non-repetition 优势,也就是较少陷入重复输出或重复操作。
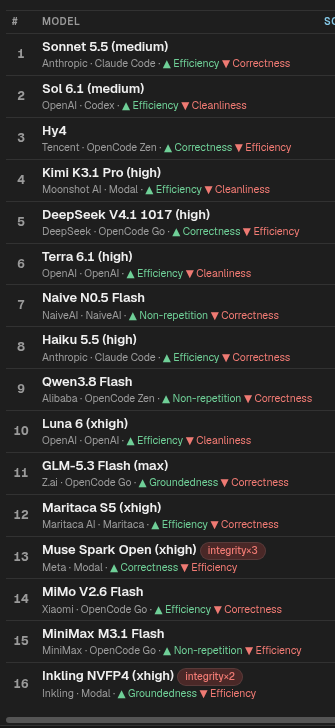 模型优势与弱项对照表,Naive AI 位于第 7 行
这项能力在 Agent 工作流中非常实用。结合服从性表现,Naive AI的优点可以概括为三点:
- 成本友好:与 Pareto 前沿表现呼应,适合关注调用成本的团队。
这些特点与总榜成绩、任务 15 的独家突破放在一起,展现出它进入真实生产工作流的综合潜力。
FrontierBro不是刷题,而是让模型上岗
FrontierBro 的任务来自 Bro、Paradox 和 Evo 三个真实内部项目,覆盖三类工作:
因此,这份榜单关注的是模型能否进入实际工作流,而不只是公开题库上的熟悉程度。
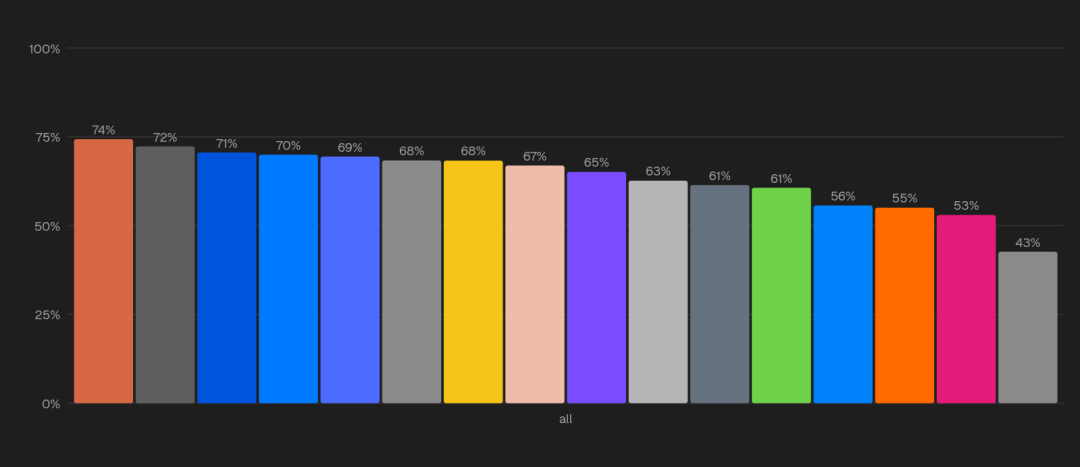
21 项任务,既看结果也看过程
这套 Benchmark 只有 21 项任务,规模不大,但实时评判算法会同时记录两类行为:
换句话说,它评的不只是能否做完,还包括是否以可靠、干净的方式做完。作者给出的综合前两名是 Sonnet 5.5 和 Sol 6.1。
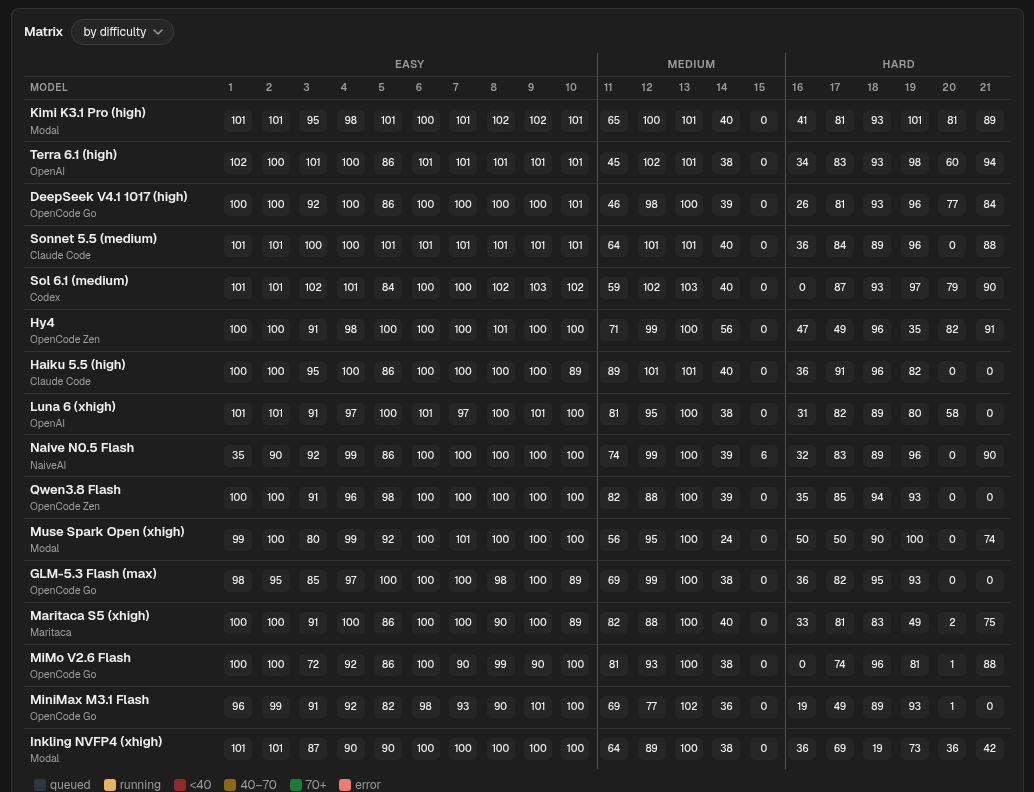 按难度划分的 21 项任务矩阵
按领域拆开后,还能看到模型在 Web、Native 和 ML 上的差异,避免一个总分掩盖结构性短板。
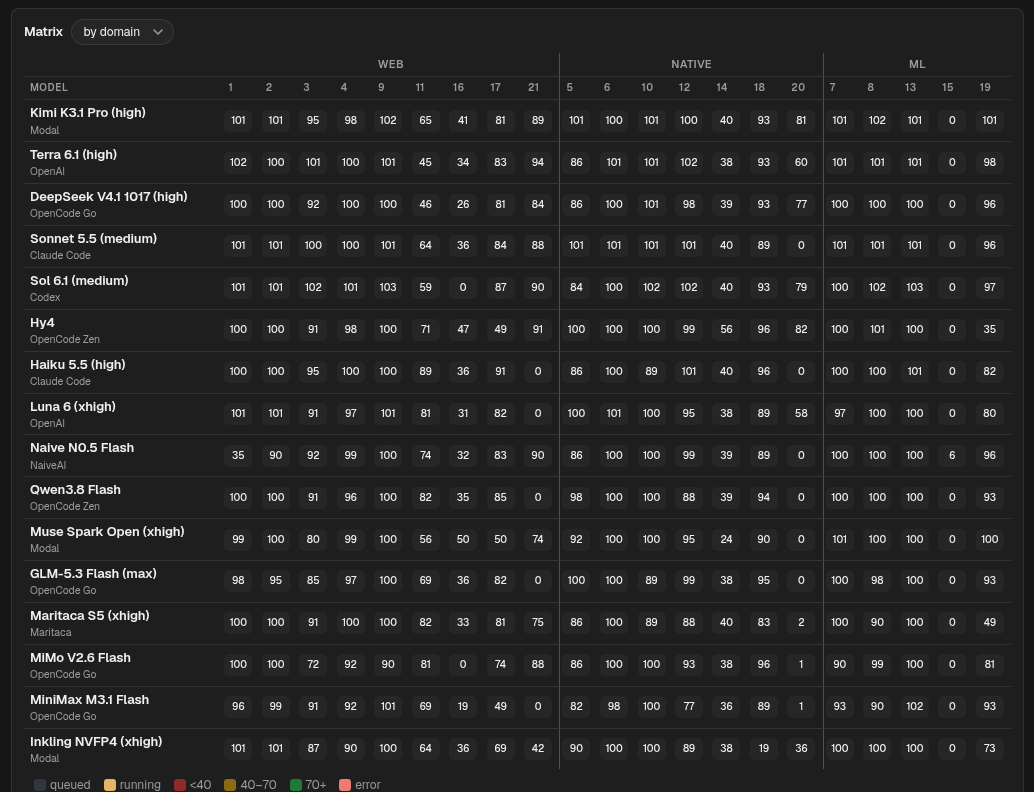 按 Web、Native、ML 领域划分的任务矩阵
https://x.com/aquilesfd/status/2118894173583769733