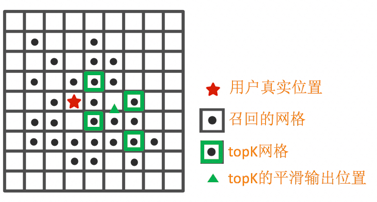
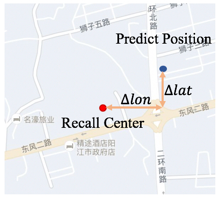
在线定位算法共经历了无监督概率模型、有监督回归模型、端到端CNN模型三次大的迭代。前两个阶段的网络定位主要包括网格召回、网格排序、网格平滑三步,如下图图一所示。端到端CNN模型去除了网格排序和网格平滑,基于一个召回中心点,直接回归位置坐标,如下图图二所示。
▍2.1 无监督概率模型
网络定位要完成在线AP与离线AP指纹库的匹配,是联合概率计算的过程。以AP指纹库的信号强度分布为例,看下网格概率计算过程。
纵轴为采集数据中的AP编号,横轴为空间网格编码,相交点表示每个AP在对应网格中的采集信号强度分布。空值表示AP在对应的位置无采集数据。
以一个实时定位query信息:(AP1:RSSI=1,AP3:RSSI=0)为例,介绍网格召回、排序、平滑的过程。
召回阶段,基于扫描到的AP1和AP3,可以召回Grid1、Grid2、Grid4;
排序阶段,结合离线AP库,基于独立性假设和贝叶斯公式,计算各网格的权重:
 表示观测到的APj的信息。以信号强度RSSI单一特征为例,上例中,
网格平滑阶段,基于上述的统计概率,排序获取TopK个网格,采用爬山法求解最优坐标:
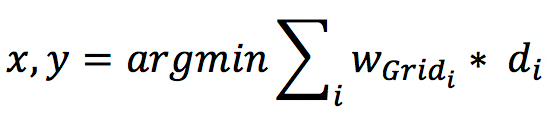
其中, 为预测位置到
 的距离。
▍2.2 有监督回归模型
无监督概率模型的方法,思路清晰易懂,易实现,是早期网络定位的主要方式。但有以下问题:
出于对以上问题的思考,整体流程仍保持网格召回、排序、平滑三阶段,我们将网格排序升级为有监督回归模型,通过引入多元特征和显式的优化目标,实现对网格的更精准打分。
Label:待预测网格与真实位置的位置偏差,回归任务。
特征工程:构建近百维特征,主要包含AP特征,网格特征,前文信息等。
模型选择:一期上线GBDT模型;二期对比了GBDT、FM、DeepFM、FM+GBDT等,最终线上最优融合模型结构如下。
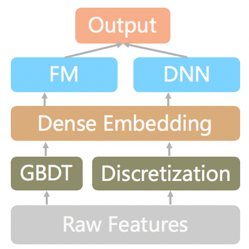
原始特征中的稠密特征和低维稀疏特征经过GBDT进行特征组合、交叉;GBDT输出的叶子节点编号与高维稀疏特征经过DeepFM网络,最终输出网格与真值的位置偏差。
TopK网格平滑:预测偏差距离从小到大排序,截取TopK网格;爬山法,梯度下降求解最优坐标。
▍2.3 端到端CNN模型
有监督模型在特征利用、模型结构、优化目标等方面提供了更大的操作空间,可以极大地打开天花板。上线后定位精度等指标取得了显著的收益。
但该方法仍有以下问题:
对于以上问题,考虑以下解决方案:
最终,整体网络结构如下:
下面以基站定位为例,介绍该结构的实现细节。
首先介绍下输入特征的构建:
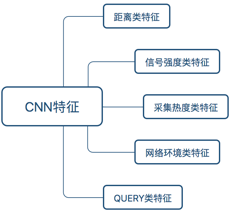
CNN特征类别
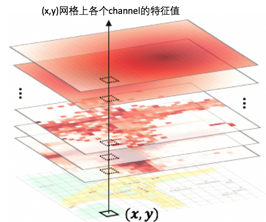
网格上各个channel的特征计算
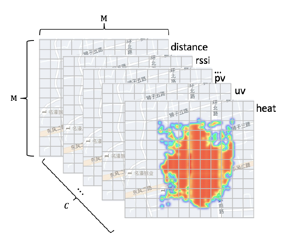
输入特征图的示例
网络结构:在CNN网络部分,采用多尺度卷积核提取特征后,经过两个卷积+池化层后,将特征图打平。Wide部分稀疏特征经过embedding后,与稠密特征级联。两部分tensor级联后经过全连接层,最终输出与召回中心点的位置偏差。
Label与Loss:label为真实位置与召回中心位置的偏移dx和dy,召回中心点+预测偏移即得预测位置。loss最初使用的是经纬度的L2 loss:
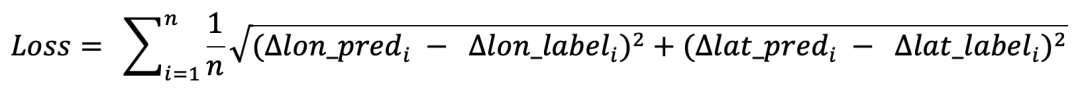
考虑到经纬度在球面上表达距离的差异,我们改为了使用球面距离偏差作为label,也获得了稳定的收益:
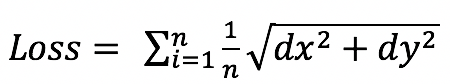
dx和dy表示真实空间距离
CNN模型在线上AB实验取得了显著的收益,已全量上线。CNN端到端模型升级了信息的表达方式,由单网格、结构化的信息表达改为了Image的表达方式,配合cnn网络结构,获取了效果的显著提升;并且将几十甚至几百个网格的预测问题改为了单次位置回归问题,虽然模型复杂度有所增加,但整体性能基本持平。
▍2.4 线上效果
网络定位三阶段的模型先后上线进行了AB对比实验。以基站定位三个主要技术指标为例,对比结果如下表所示:



