2023年,大模型(LLM)占据科技热门话题榜单的绝对C位。继ChatGPT之后,又一个大模型概念爆火,它就是具身智能(Embodied AI)。英伟达首席执行官黄仁勋在今年在一次演讲中预测:人工智能的下一波浪潮是具身智能。一时之间,具身智能机器人也成为了科技界的新风向标。那么到底什么是具身智能?11.28-11.29,我们邀请到浙江大学博士,多篇顶会一作作者Luki老师,为我们带来——具身智能引爆机器人新纪元,带我们深入探索具身智能大热的奥秘。
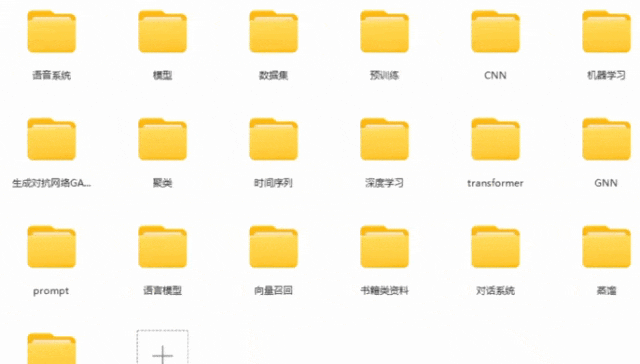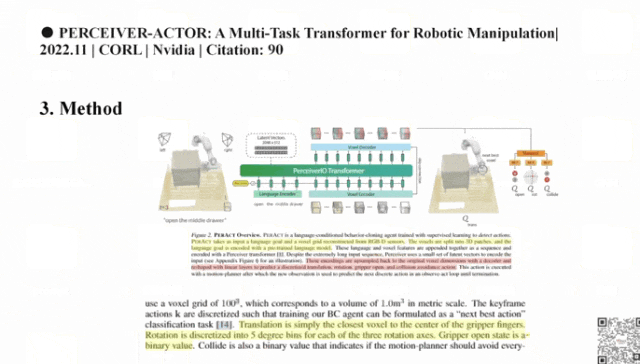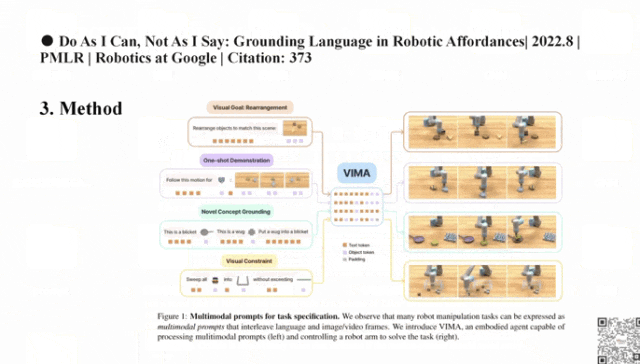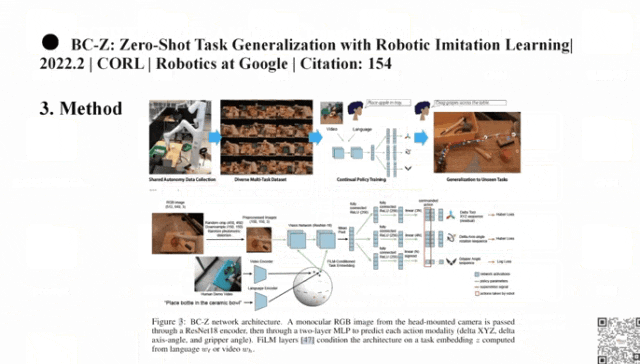
nlp方向资料&授课ppt部分展示
-浙江大学博士,具备极强的学术届和工业界
-发表多篇SCI国际期刊,包括一区期刊IEEE Transactions on Circuits and Systems for Video Technology(影响因子5.875),Biomedical Signal Processing and Control(影响因子5.076),CCF-A类会议论文AAAI等。发明专利授权2项
-长期担任计算机视觉、人工智能、多媒体领域顶级会议和期刊PRCV, WACV, TCSVT等审稿人
-研究领域:人体动作分析、人体姿态、LLMs for robotics等
1.文本大模型风靡全球,受到了广泛关注和应用,原因为何?
2.针对机器人零样本任务可以进行什么探索?
所谓具身智能机器人,即具有主动性的第一人称智能,其本质上是可与环境交互感知,能自主规划、决策、行动,具有执行能力的机器人。其核心目标是能够听到人类语言,然后分解任务,规划子任务,在移动中识别物体,与环境交互,最终完成相应任务。
针对机器人任务,也有类似于“ Vision-Language-Action Models Transfer Web Knowledge to Robotic Control( RT-2)”的模型,对机器人零样本任务进行了探索。RT-2真正出彩的地方,在于其训练的范式,可以从大规模的网络数据中获得知识,并将其与机器人数据结合,实现对新物体的更好泛化能力、对语义指令的解释能力以及对用户命令的基本推理能力。其训练的过程大致分为以下三步:1.文本图像模型预训练:使用大规模的网络数据对视觉-语言模型进行预训练。这些模型可以处理图像和文本,并生成输出标记,让模型初步具有常识推理的能力;2.机器人数据微调:使用机器人轨迹数据微调模型,使之能够输出机械臂末端点可执行的动作,初步得到Vision-Language-Action(VLA)的model;
3.联合微调:将机器人轨迹数据和web级别的vqa数据进行共同微调,在训练阶段保证数据占比近似1:1,保证模型不损失常识推理的能力。
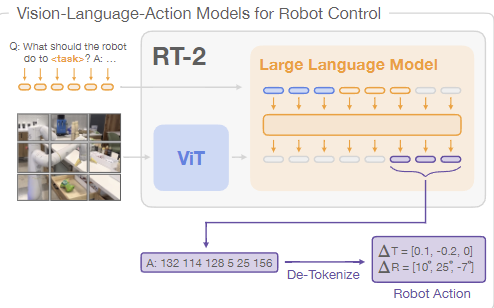
近期,Google将RT-2定位为新型的视觉语言动作(VLA)模型,实现了视觉语言模型与机器人动作的结合。RT-2一方面吸收了VLM语义推理、问题解决、视觉解释能力,另一方面能够从真实的机器人动作中实现具身任务推理,且两方面能够相互促进。训练方式上,通过将机器人动作拆解为文本token的形式,实现了直接与视觉语言数据混合后输入VLM进行联合微调。此外,Google还专门开发协议,将模型部署在多TPU云服务实现实时推理。实验结果表明,基于现成的VLM模型PaLM-E和PaLI-X,RT-2取得了良好的泛化和涌现性能。
nlp方向资料&授课ppt部分展示
作为一个科研小白,怎么发表一篇优质论文?
为了论文,大家都在努力的设计新网络、新策略、新training算法,只要能够在某一问题上做到一个很好的performance,论文就水到渠成。而想要快速达到,来自前辈的指点不可或缺。
一个好的指导老师的作用是,没有课题,能够结合所在课题组具体情况,结合最近热门研究方向,帮你规划课题,如果有了课题而缺少创新方向,老师能够快速帮你找到几种切入点,几种框架,甚至连需要读哪些文献都帮你想好了......
小沃整理了沃恩智慧联合创始人Paul老师的精品系列付费课程,原价3999元,现0元免费领,包含计算机领域各方向热点内容及论文写作技巧干货!